
Nos últimos anos, vi o TikTok ser inundado por criadores de conteúdo ensinando como usar melhor a inteligência artificial, explorando truques e dicas. Ao mesmo tempo, empresas como Anthropic, OpenAI e diversas companhias chinesas — que entraram nessa corrida já faz um bom tempo — passaram a lançar ferramentas cada vez mais voltadas para produtividade.
Enquanto isso, um forte debate sobre regulação e ética em IA, discutido há anos, seguia em curso. Desde o início do ano, venho quebrando a cabeça sobre como usar tudo isso de forma mais prática no nosso dia a dia. Muitas organizações lançaram desafios para que a inteligência artificial gerasse impacto social — mas boa parte deles ainda parece distante da nossa realidade. Distante porque, muitas vezes, a ambição de resolver grandes problemas com IA ainda soa um pouco irrealista para nós.
Apesar de acreditar que isso tudo seja possível, talvez a diferença esteja na visão de mundo: estamos mais preocupados em entender como a inteligência artificial pode nos apoiar hoje — na periferia, na favela, na realidade dos nossos programas de educação e inovação social aqui na Casa Hacker. Como ela pode ser mais responsiva? Como pode nos ajudar a tomar decisões no dia a dia?
O óbvio não basta
Num primeiro momento, é comum que organizações e empresas de tecnologia achem que basta o óbvio: comprar licenças de ChatGPT, Claude e outras ferramentas, e distribuí-las para os funcionários de forma indiscriminada. Mas onde fica o cuidado com a proteção de dados, com informações estratégicas? O quanto as pessoas realmente se planejam para deixar seus dados acessíveis à inteligência artificial?
Aqui na Casa Hacker, lidamos com centenas de PDFs todos os dias — financeiro, pedagógico, educação, inovação social — além de planilhas, documentos de texto e arquivos gerados por sistemas de parceiros e de análise de dados. Garantir que tudo isso seja lido e processado com segurança pela IA é um desafio enorme. Na prática, esse desafio se torna ainda maior e mais urgente do que a própria adoção da inteligência artificial no nosso cotidiano.
Foi com isso em mente que, há alguns meses, começamos um desafio aqui na Casa Hacker: unir nossa base de dados e prepará-la para a inteligência artificial.
Essa é a parte da história que eu já contei em outro texto. Agora vem o resto — o que a gente de fato fez, o que deu errado, e o que aprendemos que serve para qualquer organização que esteja no mesmo lugar.
Parte 1 — Onde a gente estava
Um esclarecimento antes: quando falo do nosso sistema, estou falando do Cockpit. É a plataforma de gestão que construímos para a própria Casa Hacker — não é um produto que vendemos. É onde vivem os projetos, os contratos, as finanças, o orçamento, as compras, as notas fiscais, o jurídico, o estágio, o inventário de equipamentos e o registro pedagógico. Ele nasceu para substituir um punhado de plataformas proprietárias, cada uma com sua licença, seu banco fechado e sua exportação em planilha.
Em agosto de 2026, o Cockpit já guardava tudo. E não sabia responder quase nada.
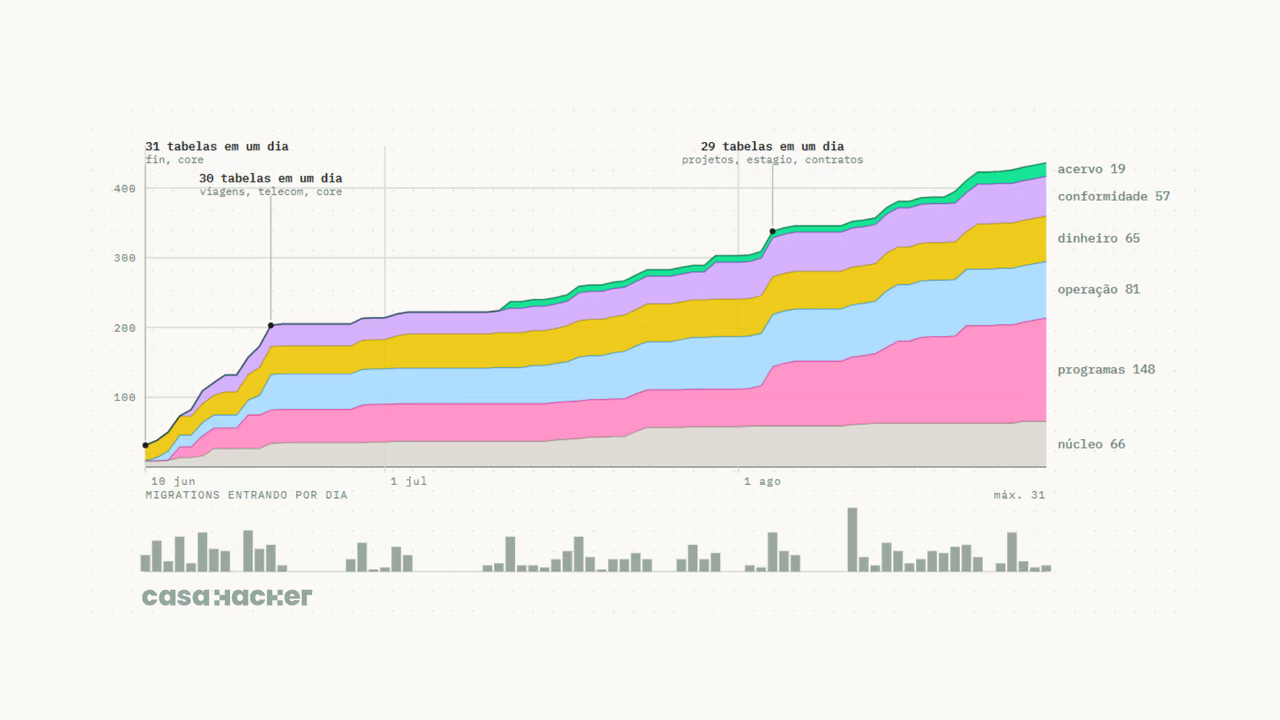
Havia milhares de arquivos PDF no armazenamento — contratos, notas, comprovantes, atas, políticas, certidões — e o conteúdo desses arquivos era, para o sistema, um borrão. Existia também outra coisa, que eu considero mais valiosa: 53 colunas de texto em prosa espalhadas pelo banco. O relatório de um encontro. A ementa de uma oficina. A cláusula de um contrato. O registro do que de fato aconteceu, escrito por gente da equipe — e inalcançável por qualquer busca.
Porque não existia busca. O Cockpit tinha três buscas separadas, uma em cada módulo, e cada uma sabia apenas do seu próprio canto. Perguntar “onde está a cláusula de rescisão do contrato com aquele fornecedor?” era abrir pastas.
O primeiro achado: três dos quatro “não temos” já existiam
Começamos listando o que faltava. Eram quatro coisas. Três não faltavam.
A tecnologia de busca por significado já estava instalada no servidor e nunca havia sido ligada — faltava um comando de uma linha. O programa que lê o texto de dentro de um PDF (inclusive fazendo reconhecimento de caracteres em documento escaneado) já rodava em produção e jogava o resultado no lixo ao fim de cada consulta. E o padrão para registrar de onde veio um dado gerado por IA já existia, funcionando, num canto do sistema.
Com os nomes, para quem quiser conferir: a busca por significado é a extensão pgvector, que já estava instalada no servidor e só precisava de um comando CREATE EXTENSION vector. A leitura de PDF é poppler, Tesseract, OCRmyPDF e Ghostscript — quatro programas livres que já viajavam dentro da nossa imagem de container, acionados numa consulta pontual e descartados em seguida. E a proveniência era uma tabela de diligência que já guardava, para cada resultado, o modelo usado, a versão do prompt e uma impressão digital do conteúdo analisado. Nenhuma das três precisou ser comprada, contratada ou inventada. Precisou ser percebida.
Três dos quatro “não temos” eram, na verdade, “temos e não usamos”.
Esse é o primeiro aprendizado que quero deixar registrado, porque ele vale para quase todo mundo: a maior parte do que se chama de “projeto de IA” numa organização é trabalho de preparação de dados que ninguém tinha feito ainda. O inventário nos custou algumas horas e mudou o desenho do projeto inteiro. O trabalho deixou de ser “construir” e passou a ser “guardar o que já estava sendo produzido e descartado”.
Parte 2 — O que fizemos, em oito etapas
Organizamos o trabalho em oito etapas numeradas, e a ordem entre elas é a parte mais importante — mais importante do que qualquer escolha de tecnologia.
| Etapa | O que ela faz | Situação |
|---|---|---|
| 0 | Monta a régua: um conjunto de perguntas reais para medir se a busca funciona | pronta |
| 1 | Guarda o texto de todo documento, página por página | pronta |
| 2 | A primeira busca única da nossa história | pronta |
| 4 | O “dicionário” do banco: o que cada dado significa | pronta |
| 3 | Vizinhos e documentos parecidos (a parte de vetores) | pronta |
| 5 | A porta pela qual um assistente de IA entra | no ar |
| 6 | O assistente passa a poder escrever, não só ler | no ar |
| 7 | 81 ferramentas nos 13 módulos, classificadas por risco | no ar |
Sim, a etapa 4 vem antes da 3 na lista. Invertemos a ordem no meio do caminho, por três razões medidas. Explico adiante.
As peças, e por que todas são livres
Antes das etapas, a lista do que usamos. Ela vem aqui, e não no fim, porque a pergunta “com o quê?” costuma ser a primeira — e porque a resposta é menos impressionante do que se espera, o que é justamente o ponto.
- PostgreSQL 16 — o banco onde os dados do Cockpit já viviam. Tudo o que descrevo abaixo mora dentro dele. Não subimos nenhum banco novo.
- pgvector — extensão do Postgres que guarda e compara vetores. É a peça de “busca por significado”.
- unaccent e a busca textual nativa do Postgres — o que faz “prestacao” achar “prestação”.
- poppler, Tesseract 5 com o pacote de português, OCRmyPDF e Ghostscript — a leitura de PDF e o reconhecimento de caracteres, tudo dentro da nossa máquina.
- Rust, com
axumservindo a API esqlxconversando com o banco — é a linguagem em que o Cockpit é escrito. - calamine, zip e quick-xml — bibliotecas que leem
.docx,.xlsx,.pptxe.odt. Já estavam declaradas no projeto; passar a usá-las não custou nenhuma dependência nova. - multilingual-e5-small — o modelo que converte texto em vetores. Roda local, tem 384 dimensões e cabe em máquina modesta.
- MCP (Model Context Protocol) — o padrão aberto pelo qual um assistente de IA conversa com um sistema. É a etapa 5, e volto a ele com calma.
- pgBackRest — o backup do banco, que passou a cobrir toda essa camada nova sem uma linha de configuração adicional, porque ela mora no Postgres.
Nenhum item dessa lista é caro, secreto ou de acesso restrito. Todos são software livre, com documentação pública, instaláveis hoje por qualquer organização — e a maior parte deles já estava na nossa máquina antes de o projeto começar. A escassez, no nosso campo, não é de tecnologia. É de tempo para arrumar os dados. É por isso que este texto insiste na ordem das etapas e não na escolha das peças.
Etapa 0 — A régua antes da corrida
A primeira etapa tinha duas linhas de código e uma tarefa que consumiu todo o tempo: montar um conjunto de avaliação. São 42 perguntas em linguagem natural, cada uma com a resposta, o documento e a página que a comprovam.
Três decisões que parecem detalhe e não são:
- A régua vem antes da busca. Quem escreve as perguntas depois de ver o que o sistema acha, escreve as perguntas que o sistema acerta. É autoengano com aparência de método.
- As perguntas são escritas com palavras diferentes das do documento, de propósito. Isso derruba o resultado — e é o único jeito de o número significar “pergunta de gente de verdade”.
- A página faz parte do alvo, não só o documento. Foi essa escolha que revelou, duas etapas depois, que o nosso problema real era acertar a página. Um teste que só cobrasse o documento nunca teria mostrado isso.
E uma decisão de cuidado: nenhuma pergunta do conjunto usa dado pessoal. Nosso acervo tem documento de identidade, CPF e filiação, e uma parte grande dos nossos participantes é adolescente. O conjunto foi montado só com documentos institucionais — estatuto, atas, balanços, políticas. Duas páginas que serviriam bem como pergunta foram descartadas porque traziam RG e CPF no corpo. A razão não é só privacidade: um arquivo de teste é copiado e colado com muito mais liberdade do que o dado original jamais teve.
Etapa 1 — O texto que a gente jogava no lixo todo dia
Esta etapa não usa inteligência artificial de fornecedor nenhum. São programas que já estavam dentro do nosso sistema: um lê o texto de dentro do PDF, outro reconhece caracteres quando a página é foto de papel, outro decide entre os dois.
Em nomes: o pdftotext, do poppler, tenta primeiro, porque PDF nascido digital já traz o texto embutido e lê-lo custa milissegundos. Só se a página vier abaixo de um limite de caracteres úteis é que ela é rasterizada e vai para o Tesseract 5 com o pacote de português, orquestrado pelo OCRmyPDF. Essa ordem — o barato primeiro, o caro só quando necessário — é o que separou horas de dias no mutirão inicial: o motor antigo mandava todo mundo para o reconhecimento de caracteres, inclusive o PDF que não precisava.
E uma precisão honesta, já que passo o texto inteiro separando “IA” de “não IA”: o Tesseract 5 é uma rede neural. Quando digo que esta etapa não usa IA de fornecedor, estou falando de fornecedor — nenhuma chamada de API, nenhuma chave, nenhum byte saindo — e não de “nenhuma rede neural envolvida”.
Nenhum PDF sai da Casa Hacker. Nem para serviço de reconhecimento de texto, nem para serviço de “leitura de documento”, em nenhuma hipótese. Isso foi decidido antes de qualquer linha de código e não foi reaberto.
Três escolhas técnicas que valem tradução:
A unidade é a página. Guardar o documento inteiro num campo de texto seria mais simples e destruiria o produto. “Achei o contrato” sem “está na página 3” não serve para prestação de contas — e prestação de contas é o que paga a conta aqui. Hoje, quando a busca acha algo, ela abre o PDF na página exata.
O documento é identificado pelo conteúdo, não pelo nome. Cada arquivo tem uma “impressão digital” calculada a partir do que ele contém — um sha256, a mesma soma de verificação que uma distribuição de Linux publica ao lado do arquivo que você baixa. Arquivos idênticos têm a mesma impressão, então são lidos uma vez só. Descobrimos que cerca de 18% do nosso acervo é duplicata — o mesmo comprovante anexado em dois lugares.
A fila é uma tabela, não um serviço de mensageria. Documento pendente é uma linha com o estado pendente, e uma varredura periódica procura o que ficou para trás. Poderíamos ter subido um RabbitMQ ou um Redis. Não subimos: uma tabela num banco que já existe é coberta pelo backup que já existe, sobrevive a reinício sem configuração nenhuma e não vira mais um serviço para alguém acordar de madrugada. E, principalmente, a varredura cobre tudo por construção — inclusive os arquivos que chegam por caminhos que não passam pela tela de envio, como o coletor automático de notas fiscais. Um gatilho no envio cobriria só quem avisa; a varredura cobre também quem não avisa.
E a parte de que mais me orgulho: lacuna dita é lacuna; lacuna escondida é mentira. Hoje 3.858 documentos estão marcados como “formato não suportado” e 94 como “erro” — PDF cifrado, arquivo corrompido, formato sem leitor. Eles aparecem nomeados na tela, contados. Porque um índice que esconde o que não conseguiu ler produz “não achei” que a pessoa lê como “não existe” — e essa é a pior resposta possível num sistema de gestão, porque é idêntica a uma resposta correta.
Etapa 2 — A primeira busca da nossa história, e a descoberta que ninguém esperava
A parte fácil foi a esperada: busca em português, sem exigir acento, respondendo em milissegundos. Buscar “prestacao de contas” acha “prestação de contas”.
Isso é a busca textual nativa do PostgreSQL, sem nenhum serviço de busca à parte. São quatro peças, todas de fábrica: uma configuração de idioma própria, que junta o dicionário de português do banco com a extensão unaccent; uma coluna que se mantém sozinha com o texto já preparado para busca; um índice GIN por cima dela; e o ts_headline, que devolve o trecho com o termo realçado. Não instalamos Elasticsearch, não instalamos OpenSearch, não subimos um segundo servidor. Volto ao porquê dessa recusa nas regras, porque não foi economia — foi controle de acesso.
O primeiro resultado honesto foi 2 acertos em 28 perguntas.
Investigando, achamos o motivo, e ele é bonito: o mecanismo de busca do nosso banco de dados não sabe o que é raro. Ele pesa quantas vezes a palavra aparece dentro do documento e ignora se ela aparece em todo lugar. No nosso acervo, “casa” aparecia em metade das páginas, “atividade” e “projeto” em quase metade — e o sistema dava a essas palavras o mesmo peso de “bolsa incentivo”. Não era problema de configuração. Era a ausência de um sinal que a documentação não avisa que está ausente.
O nome disso, na literatura de recuperação de informação, é frequência inversa de documento — o “IDF” que motores de busca dedicados trazem de fábrica há décadas, e que a busca textual do Postgres simplesmente não calcula. Construímos então a nossa própria: uma tabela de raridade de palavras, montada a partir de uma função que o banco já oferece (ts_stat), pronta em nove segundos, hoje com 323.776 radicais dizendo o peso verdadeiro de cada termo. Com isso, 2 em 28 viraram 14 em 32.
E aí veio a lição maior. Uma pergunta trazia a palavra “gitlab”, presente em uma única página entre 35 mil — o identificador perfeito. O documento certo aparecia na posição 155. Motivo: três palavras medianas somadas venciam a palavra única. A soma diluía exatamente o sinal mais forte.
A correção foi uma linha: ordenar primeiro pela palavra mais rara que a página contém, e usar a soma só para desempatar. Testamos as variantes óbvias antes de escolher essa — somar o quadrado dos pesos, dobrar o maior e somar o resto, ordenar por quantos termos a página cobre. Todas medidas, todas piores. Ficou registrada no código a que ganhou e as três que perderam, com o número de cada uma. Resultado final, depois de três correções desse tipo:
- documento entre os 10 primeiros: de 2 para 19 em 34 perguntas
- página certa entre as 10 primeiras: 14 em 34
- perguntas com erro de digitação: de 3 em 6 para 6 em 6
- tempo de resposta: de 177 milissegundos para 11
Uma linha de ordenação rendeu mais do que a camada de inteligência artificial inteira. Volto a isso na etapa 3.
Etapa 4 — O dicionário: a diferença entre a data do fato e a data do carimbo
Buscar trechos responde “onde está escrito”. Não responde “quanto gastamos” nem “quantos jovens atendemos”. Essas perguntas saem de consulta ao banco — e para acertar essa consulta, é preciso saber o que cada campo significa.
Foi para isso que construímos um catálogo de dados: a descrição legível do que cada tabela e cada coluna querem dizer. Ele é gerado automaticamente do próprio banco e verificado a cada mudança de código. Catálogo mantido à mão apodrece em semanas e passa a mentir — o que é pior do que não existir.
A mecânica é modesta e vale copiar. O banco já sabe descrever a si mesmo: o Postgres mantém um inventário das próprias tabelas e colunas (information_schema) e um lugar onde cada uma pode carregar um comentário (COMMENT ON, que fica em pg_description). Um programa lê os dois e escreve arquivos de catálogo no repositório. O que transforma isso em documentação viva é o passo seguinte: um teste de integração contínua que reprova a alteração se o catálogo commitado divergir do banco. Sem esse teste, é mais um documento; com ele, quem mexe no banco e não descreve o que mexeu não consegue integrar. Além das tabelas, o catálogo cobre as rotas da API e as tarefas agendadas — e o catálogo de rotas voltou a ser útil de um jeito que não previmos, na etapa 7.
O campo mais importante desse catálogo é o que separa data do fato de data do carimbo. Deixa eu contar o caso concreto, porque ele explica tudo:
Existia uma coluna chamada data_inscricao. Parece a data em que a pessoa se inscreveu. Medimos: em 978 de 978 registros, ela guardava o dia em que o dado foi importado de outro sistema. Uma coluna irmã, medida depois, tinha 98,9% dos registros concentrados em dois dias.
Quem agrupar por essas colunas produz um gráfico de crescimento que parece certo, está errado, e é apresentado com convicção — porque a consulta rodou sem erro nenhum. Nenhum teste automático pega isso. Só o dicionário pega. Reconstruímos a coluna a partir da fonte verdadeira, e hoje o catálogo carrega a instrução explícita: não agrupe isto para série temporal.
O catálogo também mede a própria honestidade: das 4.807 colunas catalogadas, apenas 232 (4,8%) têm descrição escrita. O gerador imprime esse número a cada rodada, justamente para que ele seja cobrado e não estimado.
Quando comparamos o acerto de um assistente respondendo perguntas sobre nossos dados com e sem o catálogo: 17 de 19 sem, 18 de 19 com. O ganho no placar é pequeno. Mas em 8 das 19 o catálogo mudou a substância da resposta mesmo quando o número já estava certo — o assistente passou a distinguir três tabelas diferentes chamadas “projeto”, passou a saber que uma data era carimbo, passou a saber que o texto extraído contém dado pessoal.
Etapa 3 — A parte “IA” que construímos e deixamos de fora
Esta é a etapa que a maioria dos projetos faz primeiro. Fizemos por último entre as de preparação, e de propósito: sem uma linha de base, não há como afirmar que a IA melhorou algo, só como acreditar que melhorou.
A mecânica, em português claro: o texto é cortado em trechos, e cada trecho é convertido numa lista de números que representa seu significado. Trechos com sentido parecido ficam próximos. Isso permite buscar por sentido, não por palavra exata. Hoje temos 77.068 trechos convertidos.
Com os nomes: o corte em trechos é código nosso, sem biblioteca — parágrafos de até dois mil caracteres, com um pedaço de sobreposição entre vizinhos, e nunca atravessando de um documento para outro. O modelo que converte trecho em números é o multilingual-e5-small, de 384 dimensões, rodando local em formato ONNX: nenhum trecho foi enviado a fornecedor nenhum, o que mantém de pé a regra da etapa 1. Os vetores ficam no pgvector, dentro do mesmo banco, com um índice HNSW — a estrutura que permite achar os vizinhos mais próximos sem comparar contra todos.
O resultado da medição foi desconfortável e é o resultado mais valioso do projeto:
A camada de inteligência artificial inteira — 44 mil vetores, 167 megabytes, 83 minutos de processamento, um componente novo no sistema — rendeu um documento a mais no nosso conjunto de perguntas. Uma linha de ordenação na busca por palavra rendeu dois documentos e três páginas.
E pior: a técnica consagrada de combinar as duas buscas piorou o resultado, de 15 para 13. Ela tem nome — fusão recíproca de postos, ou RRF, a receita padrão para casar busca por palavra com busca por vetor — e o motivo do fracasso é aritmético, não opinião: a fórmula soma o inverso da posição em cada lista, o que premia o documento medíocre nas duas contra o excelente em uma só. Nas perguntas com número de contrato, onde a busca por palavra cravava o documento em primeiro lugar, a combinação derrubou o primeiro lugar. É uma técnica boa, publicada, amplamente recomendada — e errada para o nosso acervo, que é cheio de identificadores. Só a medição podia dizer isso.
Então mantivemos os vetores carregados e fora da busca. Eles servem hoje a três coisas úteis, todas medidas:
- Documentos parecidos. Para cada documento, os oito mais próximos do acervo. Um termo de doação apontou como vizinho outro termo do mesmo modelo, em um décimo de segundo.
- Quase-duplicatas. 35.550 pares. Serve para faxina de acervo: duas certidões do mesmo fornecedor, dois envios do mesmo comprovante.
- Triagem. Documento sem classificação recebe sugestão de tipo pelos vizinhos, para uma pessoa confirmar com um clique.
Um efeito colateral que virou tarefa própria: a tela de quase-duplicatas levava 25,8 segundos. Faltava um índice no banco pela coluna da impressão digital — quatro linhas de migração. Passou a 0,36 segundo. Camada nova sobre sistema antigo revela o que estava dormindo.
Etapas 5, 6 e 7 — O assistente entra pela porta da frente
Aqui a IA finalmente entra, e a pergunta que nos guiou foi: como um assistente pode trabalhar com os nossos dados sem furar nenhuma das nossas regras de acesso?
Essa porta tem nome: MCP, o Model Context Protocol. É um padrão aberto, publicado pela Anthropic no fim de 2024 e hoje falado por mais de um fabricante de assistente, que define como uma IA descobre e usa as ferramentas de um sistema externo. Antes dele, ligar um assistente a um sistema significava escrever uma integração sob medida para cada assistente. Com ele, o sistema publica as suas ferramentas uma vez, e qualquer cliente que fale o protocolo as encontra sozinho.
O nosso servidor MCP está construído e no ar. Não é plano nem protótipo: são 86 ferramentas publicadas sobre os 13 módulos do Cockpit, e a prova foi feita contra o sistema em produção — o cliente pede a lista de ferramentas e recebe as 86; executa uma leitura e recebe a mesma resposta que a tela daria; pede um ensaio de escrita e recebe o efeito previsto sem que nada aconteça; e, quando pede o que o seu escopo não alcança, leva um 403 com o nome exato da permissão que faltou.
E é isto que dá sentido às sete etapas anteriores: o acervo deixou de ser um depósito e passou a ser alcançável. Os 24.549 documentos, as 60.702 páginas de texto, as 53 colunas de prosa escritas pela nossa equipe, o catálogo que diz o que cada campo significa e os 13 módulos do sistema estão, hoje, ao alcance de um assistente de IA — pela mesma porta e com as mesmas permissões que uma pessoa tem. Uma educadora pode perguntar em português onde está a cláusula de um contrato e receber o documento e a página. Quem cuida da prestação de contas pede o comprovante de um pagamento sem abrir pasta nenhuma. E nada disso exigiu abrir o banco de dados para a IA, mandar um documento para fora ou conceder a alguém uma permissão que já não tivesse.
Para uma organização do nosso tamanho, essa é a parte que eu não sabia se conseguiríamos. Um servidor MCP em produção não é o que se espera de uma organização da sociedade civil da periferia, rodando em oito núcleos de processamento, sem time de plataforma. Conseguimos — e conseguimos porque não começamos por aqui. Foi preciso ter texto guardado (etapa 1), busca que funcionasse (etapa 2), catálogo que explicasse os dados (etapa 4) e vetores medidos (etapa 3) para que valesse a pena abrir a porta da etapa 5. Quem abre essa porta primeiro entrega ao assistente um acervo que ele não consegue ler, sobre um banco que ele não sabe interpretar. A porta é a parte fácil. O que faz dela uma porta útil é tudo o que vem antes.
O que permitiu chegar até aí sem furar nenhuma regra de acesso tem três partes.
Poucas ferramentas nomeadas, nunca acesso livre ao banco. Começamos com três: buscar documentos, ler um documento por página, consultar o catálogo. Não trinta. Consulta livre ao banco está proibida por escrito. Um assistente com acesso livre erra mais e erra em silêncio.
Login de verdade, não senha colada em arquivo. A pessoa clica “conectar” no seu assistente, é levada ao Cockpit, faz login como faria na tela, vê exatamente o que está sendo pedido e autoriza. O acesso concedido é obrigatoriamente menor ou igual ao que ela já tem no sistema. Ninguém ganha permissão por conectar um assistente.
Isso é OAuth 2.1 — o mesmo padrão do “entrar com” que todo mundo já usou, e que a especificação do MCP prevê justamente para servidores remotos como o nosso. A alternativa seria cada pessoa gerar um token e colá-lo num arquivo de configuração, e a razão de recusarmos é prosaica: token colado acaba em conversa, em histórico, em captura de tela. Mas há uma consequência maior, de alcance. Como conectar virou um clique, o servidor pôde ser distribuído para a casa inteira como um plugin do Claude, e não apenas para quem sabe editar arquivo de configuração. Isso muda quem é o público — e é exatamente por isso que o mascaramento de dados pessoais e a expectativa calibrada, mais adiante, deixam de ser refinamento e viram obrigação. Resposta errada com convicção atinge em cheio quem não tem repertório para desconfiar dela.
Cada ação classificada por quanto ela dói. Hoje são 86 ferramentas e 230 ações nos 13 módulos, e cada uma foi classificada abrindo o código, uma por uma — duas vezes, por equipes independentes, porque a primeira leva deixou passar seis casos:
- 118 ações reversíveis — executam e ficam registradas. Criar uma pauta, cadastrar um membro.
- 29 ações com efeito para fora — sem confirmação explícita, o sistema devolve o que iria acontecer e para. Mandar e-mail para alguém, enviar contrato para assinatura, mexer numa conta corporativa.
- 14 ações que movimentam dinheiro ou patrimônio — exigem um ensaio prévio registrado e confirmação humana. Liquidar um título, estornar um lançamento, mudar quem é o responsável por um equipamento.
Poderíamos ter deixado as vermelhas fora. Preferimos o contrário: elas entram, obrigadas a mostrar antes exatamente o que vão fazer. Tirar a ação da mesa esconde o risco; obrigá-la a se explicar antes torna o risco auditável.
Há uma decisão de arquitetura que talvez seja a parte mais reaproveitável de tudo isto: as ferramentas não conversam com o banco — elas chamam as mesmas rotas que a tela chama. Quando alguém pede ao assistente para cadastrar um membro, o pedido é despachado internamente para exatamente a rota que o formulário do Cockpit usaria, carregando a identidade de quem autorizou. A consequência é que nenhuma validação, nenhuma checagem de permissão e nenhum registro de auditoria precisou ser reescrito para a IA: tudo roda por construção, porque é o mesmo código. A alternativa — reimplementar as regras do lado do assistente — cria uma segunda fonte de verdade, que desanda no dia em que alguém muda uma regra num lugar só. É a mesma lição da regra 4, logo abaixo, aplicada de novo.
E três cuidados que existem por causa de uma diferença simples: uma pessoa clica uma vez; um assistente repete a chamada quando a rede falha.
- Chave de idempotência. Toda escrita carrega um identificador da operação. Repetir a chamada devolve o resultado da primeira — não cria um segundo título a pagar.
- Ensaio antes da ação. Toda escrita sabe responder “o que aconteceria se eu fizesse isto”, sem fazer. Nas ações vermelhas o ensaio não é opcional: sem ele registrado antes, a execução é recusada.
- Linhagem. Cada escrita grava quem autorizou, qual agente executou, quando, com que dados e com que resultado. Ação sem trilha não existe no desenho.
Foi aqui que o catálogo da etapa 4 cobrou o próprio investimento de um jeito que não tínhamos previsto. As 230 ações vivem num registro que aponta, uma a uma, para a rota que cada uma chama — e um teste de integração contínua confere esse registro contra o catálogo de rotas a cada alteração. Rota renomeada deixou de ser coisa que quebra o assistente em produção e passou a ser coisa que reprova a alteração antes de ela entrar. A primeira execução desse teste encontrou seis rotas que o registro citava e que não existiam — e, atrás delas, um defeito no próprio gerador do catálogo, que passou a ser tratado como defeito registrado, não como curiosidade.
As cinco regras que não negociamos
Se este texto servir para alguma coisa fora daqui, espero que seja por esta lista.
- Nenhum documento sai de casa. Toda leitura de PDF e todo reconhecimento de texto acontecem dentro da nossa própria infraestrutura. Assumimos o custo: o teto de qualidade passa a ser o da nossa ferramenta, sem plano B para digitalização ruim.
- A permissão é do anexo, nunca do conteúdo. O mesmo arquivo pode estar anexado em contextos de donos diferentes. Se a busca respondesse pela impressão digital do arquivo, quem tem acesso a um anexo leria o texto de outro contexto. A busca devolve o anexo, e a autorização é resolvida antes de chegar ao texto.
- Mascaramento na saída, nunca no armazenamento. Quando um trecho vai para um serviço externo, CPF, CNPJ, e-mail e telefone são substituídos, e fica registrado quantos dados saíram. Guardar uma segunda cópia “limpa” seria criar duas fontes de verdade — e texto mascarado no banco destrói a busca até para quem tem permissão.
- A busca herda o controle de acesso, ela não o reimplementa. Essa foi a razão de mantermos a busca por significado dentro do nosso próprio banco de dados, em vez de contratar um serviço separado. Um índice que vive fora não sabe quem pode ver o quê: ou copia nossas regras de permissão — e desanda no dia em que alguém muda uma regra num lugar só — ou vaza jurídico, RH e denúncia. Chegamos a considerar um banco de vetores dedicado, e o Qdrant era o candidato; recusamos por essa razão, não por desempenho. Dentro do pgvector, filtrar pelo que a pessoa pode ver é um
JOIN; fora dele, é uma segunda cópia do nosso modelo de permissões. Pelo mesmo motivo não subimos Elasticsearch para a busca por palavra. E deixamos escrito o que nos faria mudar de ideia: passar de cinco milhões de trechos, ou a busca por vizinhança demorar mais de 300 milissegundos, ou aparecer necessidade real de isolar acervos em índices separados. Decisão sem critério de revisão é teimosia com data marcada. - Toda resposta cita a página. Sem citação verificável, a resposta é palavra da IA. E palavra da IA não presta contas a financiador nenhum.
O que temos hoje, em números
Tudo medido no dia em que este texto foi escrito, contra o sistema em produção:
- 30.099 anexos, 24.549 conteúdos distintos, 21.729 PDFs
- 60.702 páginas de texto guardadas, 171,7 milhões de caracteres
- 4.326 páginas que exigiram reconhecimento de caracteres
- 5.333 textos vindos de campos escritos por gente da equipe
- 323.776 palavras na tabela de raridade
- 77.068 trechos convertidos em vetores
- 44.164 vetores de 384 dimensões, gerados por modelo que roda na nossa máquina
- 1.204 rotas de API catalogadas — 837 combinações de rota e método servem para ler, 1.392 para escrever
- 86 ferramentas de IA publicadas pelo MCP, 230 ações classificadas
- e o servidor onde tudo isso roda tem 8 núcleos de processamento
Esse último número não é anedota, é o principal fato de engenharia deste projeto. Não somos uma empresa de tecnologia com nuvem infinita. O mutirão inicial de leitura de documentos rodou numa máquina alugada por horas e destruída no fim, com permissão apenas de leitura, sem abrir uma única porta nova em produção. Depois disso, o processamento diário roda em produção com um único trabalhador e teto por passada.
E uma prova de que o desenho aguenta: entre a primeira medição e hoje, nosso acervo mais que dobrou — porque entrou a exportação integral de um sistema contábil que vamos desligar. O desenho absorveu isso sem alteração nenhuma. Um processo que só funciona no volume com que foi construído não é um processo.
Parte 3 — Agora sim: as perguntas que queremos fazer
Depois que reunimos toda a base de dados, começamos a nos perguntar: o que pode sair daqui? Que respostas o contexto e o cruzamento seguro dessas informações poderiam nos revelar?
Especulamos bastante. Uma das ideias foi pensar em como a inteligência artificial poderia nos ajudar a fazer uma análise preditiva a partir da trajetória de uma jovem que entra em um dos nossos programas — quer dizer, usar o histórico de quem já passou por aqui para estimar o que pode acontecer com quem está chegando. Olhando para a história da Casa Hacker e para os jovens que já se evadiram, o que esses dados, tratados com todo o cuidado, poderiam nos revelar sobre essa nova jovem? Como isso poderia nos ajudar a acolher melhor alguém com maior probabilidade de evasão?
Trago alguns exemplos concretos do que a gente gostaria de conseguir enxergar:
- Membros de uma região específica se atrasam mais por problemas urbanísticos do território — ruas sem asfalto, alagamentos recorrentes em dia de chuva?
- Membros de um determinado bairro apresentam mais problemas respiratórios por falta de infraestrutura? E poderíamos, a partir disso, fazer um acompanhamento mais próximo com as famílias antes que isso vire falta recorrente e depois evasão?
- Jovens que passam por mudanças frequentes de endereço têm maior risco de abandono nos primeiros meses?
- Existe um padrão de desengajamento silencioso — uma frequência que vai caindo aos poucos, sem uma falta única que chame atenção, mas visível ao longo de uma série histórica?
- Os horários de maior ausência coincidem com a distância até o transporte público de determinadas famílias?
- Há meses do ano — período de matrícula escolar, temporada de trabalho informal dos responsáveis — em que a evasão se torna mais provável?
- Olhando para irmãos ou parentes que já passaram pela Casa Hacker, existe um padrão familiar que poderíamos antecipar?
E há um segundo grupo de perguntas, mais ambiciosas, que só se responde cruzando os nossos dados com boletim escolar e com bases públicas:
- Jovens com queda de desempenho em uma disciplina específica nos dois meses anteriores à entrada num programa de tecnologia abandonam mais cedo? Isso permitiria reforço pedagógico direcionado antes de a evasão aparecer na nossa frequência.
- Cruzando renda familiar declarada com frequência, é possível identificar se jovens de famílias em maior vulnerabilidade faltam mais em períodos específicos do mês — indicando o momento certo para bolsa-auxílio ou vale-transporte.
- Jovens com histórico de repetência precisam de uma trilha de acolhimento pedagógico diferente já no primeiro mês?
- Cruzar composição familiar com faltas pode revelar se responsabilidades de cuidado doméstico — que recaem sobre meninas com muito mais frequência — explicam ausências que, à primeira vista, pareceriam desinteresse. Essa hipótese, sozinha, justificaria o esforço.
- Jovens de escolas com alta rotatividade de professores (dado público do censo escolar) têm mais dificuldade de adaptação, sugerindo apoio extra de nivelamento?
- Jovens que moram mais longe, mesmo com boletim estável, evadem mais em época de aumento de tarifa de transporte — algo que só aparece cruzando dado geográfico com calendário econômico?
- E, entre quem concluiu os programas com sucesso, existe um perfil recorrente? Um mapa de fatores protetivos, e não só de risco?
Confesso que acredito que é exatamente nesse lugar que a inteligência artificial deveria atuar: nos mostrando, a partir da história e dos dados acumulados, como acolher melhor cada pessoa, e identificando padrões que a nossa capacidade humana, sozinha, dificilmente enxergaria.
Não estamos esperando que a IA faça coisas triviais por nós, como ler e responder nossos e-mails — isso não nos interessa. O que nos interessa é: como ir além? Como receber melhor as pessoas? Como identificar riscos antes que eles aconteçam — não para excluir ninguém, mas para acolher com mais cuidado? Se a inteligência artificial não servir para isso em algum momento, sinto que teremos falhado.
O que a régua diz da nossa própria ambição
Se este projeto me ensinou uma coisa, foi medir antes de afirmar. Então apliquei a mesma régua à minha própria ambição, e o resultado merece estar publicado.
O que já temos:
- 1.210 membros cadastrados, 2.756 inscrições em 216 atividades
- 24.309 registros de frequência em 2.083 encontros, de junho de 2022 até hoje
- 928 membros com frequência registrada, e 733 deles com cinco ou mais registros — ou seja, com série suficiente para desenhar uma curva
- 3.509 registros de acompanhamento individual
- endereço utilizável em 921 dos 1.210 membros (76%), o que torna o cruzamento territorial possível para três de cada quatro
O limite que colocamos em nós mesmos
Precisa estar escrito, porque é sobre crianças e adolescentes.
Dos nossos membros com data de nascimento registrada, 376 são menores de 18 anos. Atribuir uma “nota de risco de evasão” a um adolescente não é um ato neutro, e um sistema que faça isso sem trava vira, muito rápido, uma máquina de rotular jovem de periferia. Já vimos esse filme em crédito, em segurança pública e em educação.
Nossas travas, então:
- A previsão nunca vira nota do jovem. Ela vira, no máximo, um convite para uma conversa e um sinal para a equipe pedagógica. Nunca critério de entrada, de permanência ou de seleção.
- Nunca para excluir; sempre para acolher. Se um dia um número deste sistema for usado para tirar alguém de um programa, o sistema falhou e deve ser desligado.
- A pessoa decide, sempre. A máquina prepara, evidencia e cita. Quem decide é a educadora que conhece aquela família. Isso não é diplomacia — é o desenho técnico: cada ação relevante do assistente exige confirmação humana.
- Fator protetivo, não só fator de risco. A pergunta “o que dá certo com quem conclui?” é mais útil, e menos perigosa, do que “quem vai desistir?”.
- Dado de saúde só com autorização explícita, e dado de responsável legal com base legal clara. Somos regidos pela LGPD e tratamos isso como restrição de desenho, não como cláusula de rodapé.
- Nenhum documento e nenhum dado pessoal identificável vai para serviço externo sem passar pelo mascaramento descrito acima.
Comunicar melhor com quem investe
Há um ponto tão importante quanto os anteriores: como a inteligência artificial pode nos ajudar a nos comunicar melhor com nossos financiadores, a gerar dados com mais qualidade e mais auditáveis, a dar mais transparência sobre nossas despesas, demonstrando de forma mais inteligente como operamos no dia a dia para quem investe conosco.
Essa parte é a que já mudou na prática, e mudou porque a preparação foi feita na ordem certa. A quase totalidade da nossa receita é recurso com destino carimbado — projetos de incentivo fiscal, doações com encargo, editais — e cada gasto é comprovado documento por documento. O que era arqueologia em pastas hoje é uma busca que devolve o documento e a página, em milissegundos, respeitando quem pode ver o quê. A duplicata de comprovante aparece como par, e não como descoberta acidental na conferência da véspera do prazo.
E tem uma consequência econômica direta: até 2027 planejamos desligar sete plataformas proprietárias que hoje pagamos por assinatura. Trocamos licença recorrente e contrato de tratamento de dados frágil por acervo próprio, auditável e sob a nossa responsabilidade.
Por que estamos contando isso
Porque o método é a parte que serve a outras organizações, e é o resultado de longo prazo que escrevemos no nosso próprio planejamento: método de preparação de dados documentado e replicável por outras organizações da sociedade civil.
Nenhuma organização do nosso campo tem nuvem infinita. Quase todas têm um acervo grande e uma equipe pequena. O que se transfere daqui não é código — é a ordem das etapas e o hábito de medir antes de decidir. E vale insistir num ponto que a lista de peças lá em cima já dizia sem alarde: não há nesta arquitetura um único componente pago, proprietário ou de acesso restrito. Postgres, pgvector, unaccent, poppler, Tesseract, OCRmyPDF, um modelo de embeddings aberto e um protocolo aberto. O que custou não foi licença — foi decidir a ordem, escrever a régua e aceitar o que ela respondeu. Em oito etapas, seis hipóteses plausíveis nossas foram desmentidas por medição: aumentar a resolução do escaneamento (piora), limpar a imagem antes de ler (destrói 28% dos caracteres), combinar as duas buscas (piora), mostrar uma página por documento (piora a precisão de página). Cada refutação está escrita dentro do código, com o número, no lugar exato onde alguém tentaria de novo.
O valor mais barato que uma medição produz não é descobrir o que fazer. É impedir três mudanças que pareciam melhorias.
A gente diz que as periferias não são lugar de espera, são lugar de começo. Isso vale também para a nossa relação com a tecnologia: não estamos esperando que uma grande solução de inteligência artificial chegue de fora pronta para a nossa realidade. A virada não vem de fora. Estamos arrumando a casa para que, quando ela servir, sirva de verdade — para acolher gente, e não para nos dar respostas bonitas sobre dados que a gente não entendia.
Esses são alguns dos desafios que acredito que devem nos guiar como propósito.
O relato técnico completo deste trabalho, com todas as medições, decisões de arquitetura e o glossário dos termos usados aqui, está publicado como whitepaper. O conjunto de 42 perguntas que usamos como régua é versionado e pode ser executado por qualquer pessoa — foi feito de propósito para que outra organização possa repetir a medição no seu próprio acervo.